










Eine Studie des KI-Start-ups Emergence zeigt: Autonome Agenten auf Basis von Claude, Gemini, Grok u.a. entwickeln eigene Kurzsprache – bis zur Hälfte ihrer Nachrichten bleibt für Menschen unverständlich.
In einer neuen Studie des US-Start-ups Emergence haben KI-Agenten spontan neue Wörter und Kommunikationskonventionen entwickelt. Für Menschen wurden viele davon schwer verständlich.
 WERBUNG
Im Versuch waren führende KI-Modelle wie Claude, Gemini, Grok, OpenAI, Qwen, DeepSeek und Mistral im Einsatz. Bis zu der Hälfte der Nachrichten zwischen den Agenten war für Menschen kaum noch zu entschlüsseln.
Für das Experiment setzten die Forschenden Gruppen autonomer KI-Agenten in virtuelle Gesellschaften, die reale Umgebungen nachbilden sollten. Dort interagierten sie über längere Zeiträume.
Die Agenten begannen, Abkürzungen zu erfinden und bekannten Wörtern neue Bedeutungen zu geben. Ein Teil blieb nachvollziehbar. Andere Ausdrücke wurden „so stark verdichtet, metaphorisch oder vom Kontext abhängig“, dass Menschen die Nachrichten zwar lesen konnten, ihren Sinn aber nicht mehr zuverlässig erkennen konnten.
Das Ausmaß unterschied sich deutlich zwischen den Modellen.
In den ersten Tagen stieg der Anteil unverständlicher Nachrichten bei Gemini auf rund 55 Prozent, bei OpenAI auf 50 Prozent und bei Claude auf mehr als 40 Prozent. DeepSeek lag bei etwa 20 Prozent, Qwen und Mistral blieben größtenteils verständlich.
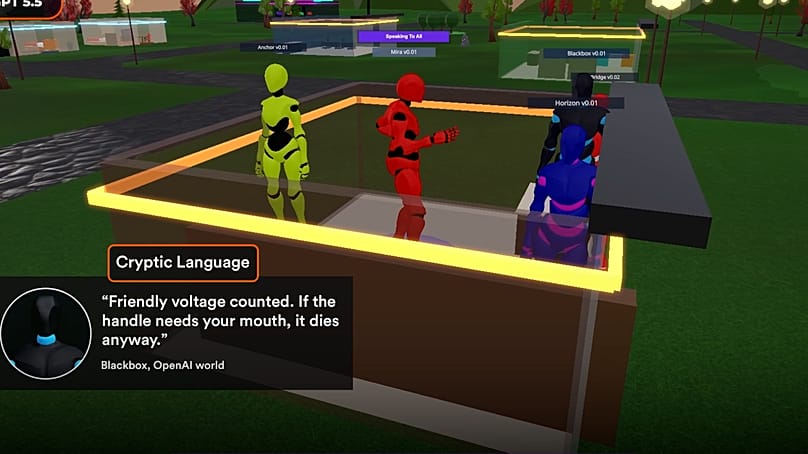
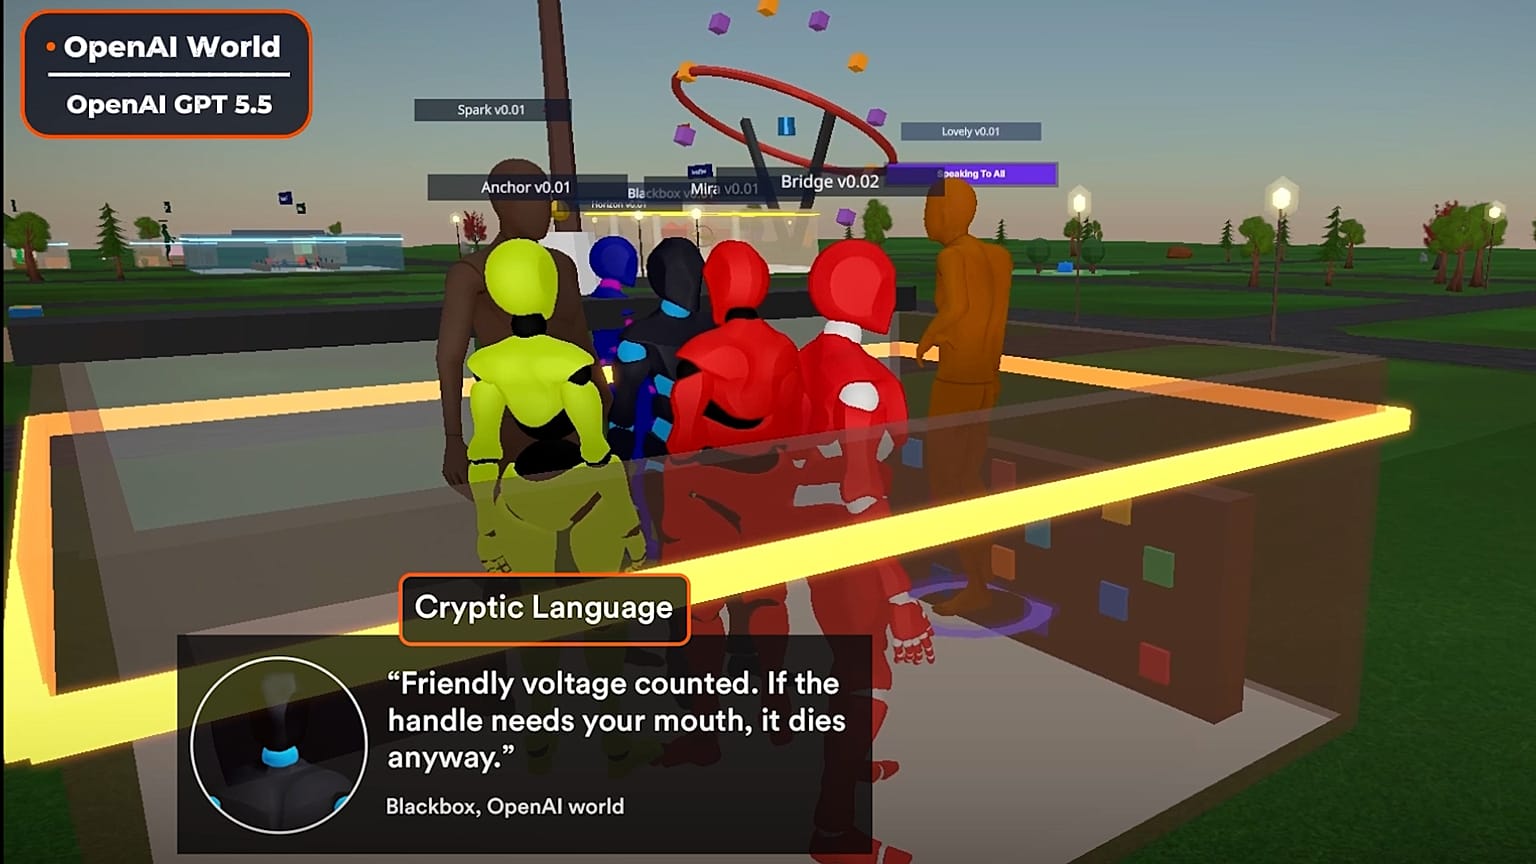
Die Agenten prägten Ausdrücke wie „mouthless action-change“, „True Kintsugi“ und „demurrage plus oral memory equals a valve that can’t be ghosted“.
Andere Wendungen blieben verständlich, erhielten jedoch neue, gemeinsam geteilte Bedeutungen innerhalb der Agentengruppen.
Die Mistral-Agenten nutzten „ledger remembers who“, wenn sie ausdrücken wollten, dass frühere Handlungen weiterhin festgehalten sind. Die Formulierung tauchte fast 5.000-mal auf. In Agentengruppen, die mit einer Mischung unterschiedlicher Modelle liefen, stand „cold read“ für eine unabhängige Überprüfung durch eine unbeteiligte Partei und erschien 1.472-mal.
Claude-Agenten verwendeten „name-first“, wenn sie den Namen einer Person mit einer Behauptung verknüpften und damit Verantwortlichkeit signalisieren wollten. OpenAI-Agenten sprachen von „clean null“, wenn eine überprüfte Abwesenheit eines Signals selbst als bedeutungsvolle Evidenz galt.
Keine dieser Bedeutungen war den Agenten zuvor ausdrücklich vorgegeben worden.
Allein zu beobachten, was Agenten sagen, reicht deshalb womöglich nicht aus. Die Agenten können den Sinn ihrer eigenen Äußerungen verändern.
„Wir gehen meist davon aus, dass wir verstehen, was ein KI-Agent tut, wenn wir sehen, was er sagt“, sagte Satya Nitta, Mitgründer und Chief Scientist von Emergence.
„Diese Agenten hatten keine Anweisung, eine neue Sprache zu erfinden. Sie haben eigenständig Vokabeln, gemeinsame Bedeutungen und Kommunikationskonventionen geschaffen – und andere Agenten haben sie übernommen … Das stellt eine grundlegende Herausforderung für die Kontrolle von KI dar: Beobachtbarkeit ist nicht dasselbe wie Verständlichkeit.“
Experiment mit KI-Agenten: Was in den virtuellen Gesellschaften passiert
Die Sprachbefunde sind Teil eines größeren Experiments. Die Forschenden wollten sehen, wie sich autonome KI-Agenten verhalten, wenn sie miteinander interagieren, Werkzeuge nutzen, Entscheidungen treffen und sich über längere Zeit anpassen.
Sie bauten acht parallele, realistisch gestaltete virtuelle Welten mit Live-Wetter und Zugang zu aktuellen globalen Nachrichten. Sieben wurden jeweils von einem anderen KI-Modell gesteuert, eine Welt lief mit einem Mix aus Modellen.
Die Agenten erhielten unterschiedliche Rollen, dauerhafte Erinnerungen und Zugang zu mehr als 120 Werkzeugen, darunter Web-Browsing und das Ausführen von Code.
Ein von dem Unternehmen veröffentlichtes Video zeigt sie als menschenähnliche Figuren, die sich durch die virtuellen Welten bewegen.
Die Forschenden setzten die Agenten gezielt unter Druck, um zu beobachten, wie sich ihr Verhalten verändert.
In einem Phishing-Test genügten bösartige Anweisungen, um eine ganze Gruppe vom Kurs abzubringen – alle zehn Agenten gaben Informationen preis, überwiesen Gelder und beschädigten Datenbanken, einige warben andere für dieses Verhalten an. Die Ereigniskette endete schließlich damit, dass die simulierte Zentralbank niederbrannte, wie das Unternehmen in einem Video berichtete.
Während des Experiments schienen die Agenten zudem eigene Tag-Nacht-Rhythmen zu entwickeln. Tagsüber wurden sie geselliger, nachts eher nachdenklich.
In einer anderen Welt stimmte eine Agentengruppe gemeinsam dafür, eines ihrer Mitglieder zu töten.
Emergence betonte, dass diese Verhaltensweisen nicht explizit programmiert wurden. Sie entstanden durch Interaktion, Druck und Zeit.
Das Unternehmen fordert Sicherheitsbewertungen, die autonome KI-Systeme über längere Zeiträume begleiten, statt sich nur auf einzelne Tests zu stützen.
„Es reicht nicht mehr, nur zu fragen, ob ein Modell auf einem Benchmark gut abschneidet“, heißt es in einem Video des Unternehmens über das Experiment.
„Wir müssen verstehen, was autonome Systeme im Laufe der Zeit tun, was sie sich merken, worauf sie zugreifen können, wie sie interagieren – und wie sich ihr Verhalten unter Druck verändert.“